Week 1 学习成果|复杂度实测、对象模型与数据结构实战
Week 1 的实际产出:Day 2 复杂度实测与对照表、Day 3 object_model.md 全文、Day 4 数据结构实战的解法与总结。
本篇是 Week 1 的学习成果,与学习计划分开成文:计划篇保留当时的任务与要求,这里集中放实际做出来的东西和实测数据。目前有书面成果的是 Day 2–4,Day 5–7 完成后再补进来。
成果:Day 2 复杂度实测 | Day 3 object_model.md | Day 4 数据结构实战
Day 2 成果|复杂度实测与对照表
对应计划:Day 2|List / Dict / Set + Big-O
实验方法(Python 3 + timeit,repeat=5 取均值):
- 计时:
timeit.timeit(lambda: func(data), number=N) / N,得到单次操作耗时 - 每轮测试前重新 copy 干净数据,且 copy 不计入计时
- search 测“查找不存在的值 n”(最坏情况),避开“搜第一个元素”的最好情况陷阱
- dict set / set add 用不存在的新键,测真实插入而非覆盖
实测数据(单位:秒/次):
| 操作 | n=1,000 | n=10,000 | n=100,000 | 增长规律 |
|---|---|---|---|---|
| list index | 1.07e-7 | 1.13e-7 | 1.09e-7 | 恒定 → O(1) |
| list append | 9.4e-8 | 1.00e-7 | 1.25e-7 | 基本恒定 → 均摊 O(1) |
| list insert(0) | 2.46e-7 | 1.58e-6 | 1.32e-5 | n×10 → 时间×10 → O(n) |
| list search | 4.73e-6 | 4.64e-5 | 4.75e-4 | n×10 → 时间×10 → O(n) |
| dict get | 1.41e-7 | 1.31e-7 | 1.40e-7 | 恒定 → O(1) |
| dict set | 2.07e-7 | 1.88e-7 | 1.92e-7 | 恒定 → O(1) |
| dict membership | 1.04e-7 | 9.5e-8 | 9.6e-8 | 恒定 → O(1) |
| set add | 1.10e-7 | 1.02e-7 | 1.00e-7 | 恒定 → O(1) |
| set membership | 9.9e-8 | 1.29e-7 | 9.1e-8 | 恒定(小幅波动为噪声)→ O(1) |
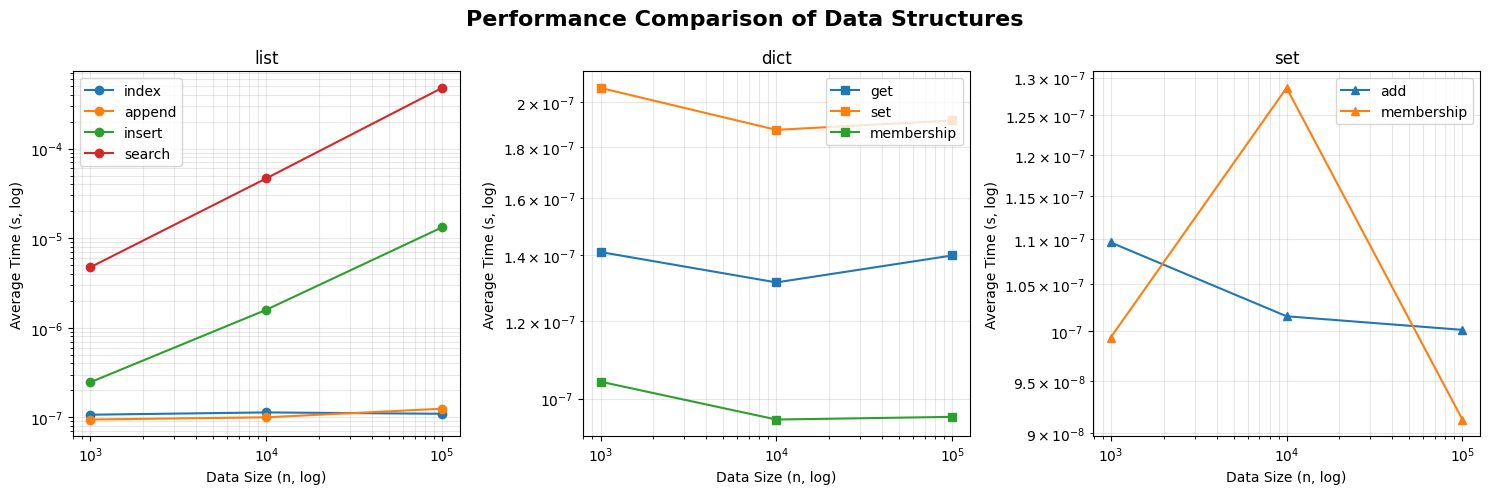
实验中的三个重要发现:
- 最好情况陷阱:最初 search 测
0 in lst,结果恒定在 ~8e-8 秒,看起来像 O(1)。改成n in lst(不存在,必须扫全表)后立刻变成标准线性增长。→ 测什么数据点,直接决定结论对不对。 - 固定开销稀释线性规律:insert 在三个规模间只增长 6~8 倍而非 10 倍,因为测得的时间 = 固定开销(lambda 调用等 ~1e-7s)+ 线性成本。减去固定开销后,倍数恢复到 ×10 / ×9。→ 小规模数据测出来的主要是调用开销,不是算法本身。
- 同为 O(n),常数差 36 倍:n=100,000 时 insert(0)(memmove 连续内存搬运)比 search(Python 层逐个比较)快约 36 倍。→ 大 O 只描述增长趋势,不描述绝对速度;真实选型要靠实测。
重点理解:
- list 为什么随机访问 O(1)
→ list 底层是连续的指针数组,
lst[i]通过「首地址 + i × 指针大小」直接算出位置,一步到位,与 n 无关。 - list 为什么头部插入 O(n) → 连续内存要保序,insert(0) 必须把后面全部 n 个元素整体后移一位(C 层 memmove)。实测 n=100,000 时约 1.3e-5 秒,随 n 线性增长。
- dict 为什么平均查找 O(1) → 哈希表:key 经 hash 函数算出槽位,直接跳过去取,不需要遍历。实测 get 在 n=1,000~100,000 间稳定在 ~1.4e-7 秒,纹丝不动。
- set 为什么 membership 平均 O(1)
→ set 本质是只有 key 没有 value 的哈希表,
x in s同样直接算槽位。实测 ~1e-7 秒,甚至比 list 的 index 还快(哈希路径更短)。 - 为什么“平均 O(1)”不等于“永远 O(1)” → 哈希冲突:多个 key 落进同一槽位时退化为链式探测,最坏 O(n)。 → rehash 扩容:元素数超过负载因子阈值时,哈希表要扩容并重新安置全部元素,单次插入瞬间变 O(n),均摊后仍是 O(1)。 → 所以大 O 有“平均/均摊”的前提;benchmark 测大量操作取平均,恰好把这个因素平均掉了。
complexity.md 复杂度对照表(✅ = 本次实测验证;未标 = 理论值,本轮未测):
| 操作 | list | dict | set |
|---|---|---|---|
| 随机访问 | O(1) ✅ | —(无索引概念) | —(不支持下标) |
| 查找 | O(n) ✅ | O(1) 平均 ✅(按 key) | — |
| 插入 | append 尾部 O(1) 均摊 ✅; insert(0) 头部 O(n) ✅ | O(1) 平均 ✅ | O(1) 平均 ✅ |
| 删除 | pop() 尾部 O(1); pop(0)/remove O(n)(未实测) | O(1) 平均(未实测) | O(1) 平均(未实测) |
| membership | O(n) ✅ | O(1) 平均 ✅ | O(1) 平均 ✅ |
原因解释:
- list:底层是连续指针数组。按下标访问是算术运算 → O(1);查找、头部插入/删除都要扫描或移动大量元素 → O(n);尾部 append 均摊 O(1)(偶尔扩容拷贝全表,摊到每次可忽略)。
- dict / set:底层是哈希表。get/set/add/del/in 都先算 hash 定位槽位,直接到达 → 平均 O(1)。代价:无序、更占内存、key 必须可哈希(不可变类型)。
- 选型口诀:按下标快速访问 → list;按 key 快速存取/判断存在性 → dict/set;频繁头部插删 → 用 collections.deque。
待补项(Day 3 或有空时):
- 补测 delete 类操作:
list.pop(0)、list.remove()、dict del、set discard - 补测 1,000,000 规模(注意调小 number,search 会很慢)
- 可选:加 collections.deque 对比
popleftvslist.pop(0)
未做的部分(delete、100 万规模)如实标注了“未实测/未测”。
Day 3 成果|object_model.md
对应计划:Day 3|Function + Scope + Copy
验收要求写一页解释 name → object → reference → scope 的文档,以下是当天产出的全文:
Day 3 验收文档 · 核心链条:名字 → 对象 → 引用 → 作用域
一、总览:一行代码里发生了什么
a = [1, 2, 3]
这一行做了两件事:
- 内存里创建了一个 list object(对象)
- 创建了一个 name(名字)
a,让它 reference(引用/指向)这个对象
a(name,标签)
   │ reference
   ▼
[1, 2, 3](object,内存中真实的数据)
赋值只是贴标签,永远不复制对象。
二、object(对象)
Python 中一切数据都是对象。每个对象有三个属性:
| 属性 | 获取方式 | 特点 |
|---|---|---|
| 身份 id | id(x) | 唯一,对象存活期内不变 |
| 类型 | type(x) | 决定对象能做什么操作 |
| 值 | x 本身 | mutable 可改 / immutable 不可改 |
mutable vs immutable
- mutable(可变):list、dict、set → 可以原地修改,id 不变
- immutable(不可变):int、str、tuple → 不能原地修改,任何“修改” 都会创建新对象,让名字指向新地方
a = [1, 2, 3]
a[0] = 99      # 原地改,id(a) 不变

s = "hello"
s = s + "!"    # 不是原地改!创建了新字符串 "hello!",s 改指向它
               # 旧的 "hello" 没人引用了,被垃圾回收
三、name 与 reference
- name(变量名)不“装”数据,只是指向对象的标签
b = a复制的是 reference,不是 object:
a = [1, 2, 3]
b = a              # b 和 a 两个标签,指向同一个对象
b.append(4)
print(a)           # [1, 2, 3, 4] ← a 也“变”了(其实是同一个对象变了)
print(a is b)      # True:同一个对象
== vs is
| 运算符 | 比较的是什么 |
|---|---|
== | 对象的值 |
is | 对象的id(是否同一个对象) |
a = [1, 2, 3]
b = [1, 2, 3]
a == b   # True  :值一样
a is b   # False :两个不同的对象
拷贝三级表
| 写法 | 效果 |
|---|---|
b = a | 只复制引用,完全共享 |
copy.copy(a) | 浅拷贝:只拷最外层,内层仍共享 |
copy.deepcopy(a) | 深拷贝:所有层级全拷,完全独立 |
浅拷贝对内层一律只传引用(不管可变不可变)。 共享 immutable 对象无害(改不了);共享 mutable 对象才有坑—— 这就是浅拷贝问题只出现在嵌套可变对象身上的原因。
四、scope(作用域)
name 通过 reference 连接 object,而**“这个名字指向哪个对象”由 scope 决定**。
LEGB 查找顺序(读取变量时)
| 层 | 含义 |
|---|---|
| L Local | 当前函数内部 |
| E Enclosing | 外层嵌套函数 |
| G Global | 模块顶层 |
| B Built-in | 内置(print、len…) |
从 L 往外逐层找,找到即停。
⭐ 最重要的一条规则:赋值即局部
- 读取一个名字:按 LEGB 向外查找
- 赋值一个名字:直接在 L 层创建局部变量,不向外查找
x = 10
def func():
    print(x)   # 读取 → LEGB 找到全局 x → 10
def func2():
    x = 20     # 赋值 → 在函数内新建局部 x,全局 x 不受影响
global / nonlocal:覆盖默认规则
| 关键字 | 声明效果 |
|---|---|
global x | x 属于全局 → 函数内赋值改的是全局变量 |
nonlocal x | x 属于外层函数 → 函数内赋值改的是外层变量 |
x = 10
def change():
    global x    # 不再“赋值即局部”,直接改全局的 x
    x = 20
change()
print(x)        # 20
不加声明却赋值,又想读写外层/全局变量 → 报
UnboundLocalError(因为赋值让名字变局部,局部还没赋值就被读取了)。
五、一句话总结
对象活在内存里(object),名字只是标签; 赋值复制的是引用; 名字指向哪个对象,由作用域规则决定—— 读取走 LEGB,赋值即局部(除非 global / nonlocal)。
Day 4 成果|数据结构实战
对应计划:Day 4|数据结构实战
三道任务的完整解法、对比和当时写下的总结。
数据去重:list 版 vs set 版
list 版本:
def drop_duplicate_list(data):
    results = []
    for i in data:
        if i not in results:  # 每次判断最坏要比对所有元素 → O(n)
            results.append(i)
    return results
set/dict 版本:
def drop_duplicate_set(data):
    results = []
    seen = set()
    for i in data:
        if i['id'] not in seen:  # 哈希查找 → O(1)
            seen.add(i['id'])
            results.append(i)
    return results

print(drop_duplicate_set(users))
复杂度比较(任务要求):
| 版本 | 单次 in 判断 | 总复杂度 | 数据量 100 万时 |
|---|---|---|---|
| list 版 | 最坏 O(n),挨个翻 | O(n²) | 10¹² 次操作 😱 |
| set 版 | O(1),哈希直达 | O(n) | 10⁶ 次操作 ✅ |
学习总结:
- 去重 = 构建新列表,不是删除原数据。边遍历边 remove 会让元素前移导致漏检(经典 bug);正确做法是原数据不动,把“第一次出现的”收集到新列表。
- 可哈希规则(踩坑:
set.add({"id":1})报unhashable type: 'dict'):- 可哈希(能进 set / 当 dict 键):int、str、float、bool、tuple
- 不可哈希:list、dict、set
- 原因:set 靠哈希值当“门牌号”定位元素,可变对象内容会变,门牌号会失效
- set 与 list 分工模式:
seen(set)只存 id 负责快速判断;result(list)存完整 dict 负责输出。set 管判断,list 管输出。
频率统计:手写 dict vs Counter
不使用 Counter:
def count_fruit(data):
    results = dict()
    for w in data:
        results[w] = results.get(w, 0) + 1
        # 键存在 → 取值+1;不存在 → 默认 0 再+1(地道写法 ⭐)
    return results

print(count_fruit(words))
使用 Counter:
from collections import Counter
print(Counter(words), Counter(words).most_common(2))
两种方案比较(任务要求):
| 能力 | 手写 dict | Counter |
|---|---|---|
| 统计 | 手写循环 | ✅ 自动 |
| 缺键 | 💥 KeyError | ✅ 返回 0 不报错 |
| 排名 | 手写 sorted 一长串 | ✅ most_common(n) 一行 |
| 运算 | 自己想办法 | ✅ c1 + c2、c1 - c2 |
学习总结:
- 演进过三种写法:①两遍扫描(先全部登记为 0 再累加)→ ②if/else 一遍扫描 → ③
results[w] = results.get(w, 0) + 1一行搞定。三种都对,get 版最地道。 - dict 的 in 查的是键:
x in d≡x in d.keys();查值要x in d.values()。 most_common(2)返回的是元组的列表[('apple', 3), ('banana', 2)],不是 dict,要按格式打印得再遍历。- 启示:遇到常见套路,先查标准库有没有现成工具(Counter 就是“为频率统计量身定做的 dict 子类”)。
"""..."""不是注释,是没被赋值的字符串;多行注释用每行#(编辑器 Ctrl+/)。
多字段排序:取负法 vs stable sort
武器 1:取负法(一次排序)
sorted(users, key=lambda u: (-u['score'], u['age'], u['name']))
武器 2:stable sort(三次排序)
user = sorted(user, key=lambda u: u["name"])                 # 先排第三优先级
user = sorted(user, key=lambda u: u["age"])                  # 再排第二优先级
user = sorted(user, key=lambda u: u["score"], reverse=True)  # 最后排主键
print(user)
sorted 与 Sorting HOW TO 的理解(任务要求必须自己理解):
- key 为什么是函数而不是直接写键名?
- dict 之间没有定义
<比较,且 Python 不知道你想按哪个字段排 - key 是“提取比较依据”的机器:每个元素先被 key 函数加工,sorted 拿返回值排队
- 数据不动、规则随传随换(
len、str.lower、lambda 都能当 key) - ⚠️
key="age"报错'str' object is not callable——key 必须是 callable - 函数是对象(Day 3)的直接应用:把 lambda 当参数传进去
- dict 之间没有定义
- 元组优先级:key 返回元组时从左到右比,第 1 位 = 主键,平手才比第 2 位。元组顺序必须和要求的优先级一字不差(踩坑:曾错写成 score, name, age,数据碰巧掩盖了错误)。取负法局限:字符串不能取负。
- stable sort(稳定排序):值相等的元素排序后保持原相对顺序。所以从最次要的键开始排——主键最后排,主键并列者保持的是上一轮排好的次要键顺序。越重要的键越晚排,越晚的越权威。
两种武器的统一心智模型:
取负法:[主键 | 次键 | 最次] ← 空间上从左到右,第 1 位最权威
三连排:最次 → 次键 → 主键 ← 时间上从早到晚,最后排的最权威
正确输出(两种方法一致):C(19,95) → B(20,95) → A(20,90)(score 并列的 B、C 由 age 升序决定)
可复用模式与待改进
# 模式 1:过滤收集(读旧的、造新的)
result = []
for item in data:
    if 条件(item):
        result.append(item)

# 模式 2:set 辅助去重/查重
seen = set()
result = []
for item in data:
    key = item["id"]
    if key not in seen:
        seen.add(key)
        result.append(item)

# 模式 3:get 频率统计
counts = {}
for w in words:
    counts[w] = counts.get(w, 0) + 1
待改进:原理理解快但代码落地慢,明日规矩——每个概念学完 10 分钟内跑第一行代码。